TPU 8tx e TPU 8i Max ampliam opções de IA do Google
Neste artigo
- TPU 8tx e TPU 8i Max atendem a cargas diferentes
- TPU 8tx combina inferência confidencial e treinamento menor
- TPU 8i Max reúne dois chips para contextos extensos
- TorchTPU e TPU Sync ampliam o suporte de software
- Preços e oferta no Brasil seguem sem confirmação
- Provisionamento exige atenção à API, à cota e à capacidade
- A escolha do acelerador começa pelas operações do modelo
- Fontes
- Perguntas frequentes
Empresas que precisam executar modelos com dados sensíveis ou processar contextos extensos são o público das TPU 8tx e TPU 8i Max, anunciadas pelo Google em 9 de novembro de 2026. Os novos sistemas ampliam a oitava geração de aceleradores de IA, com propostas diferentes para proteção durante o processamento, latência e concentração de capacidade computacional.
TPU 8tx e TPU 8i Max atendem a cargas diferentes
As novidades usam o silício da oitava geração e se juntam às TPU 8t e TPU 8i, apresentadas em abril no Google Cloud Next. O portfólio chega, assim, a quatro sistemas anunciados no mesmo ano, segundo o Google.
TPU significa *Tensor Processing Unit*: um circuito desenvolvido especificamente para acelerar aprendizado de máquina e inteligência artificial, sobretudo operações matriciais. É infraestrutura de data center, destinada a equipes que treinam e executam modelos, conforme a documentação do Google Cloud.
A divisão começou com a 8t voltada ao pré-treinamento em grande escala e a 8i direcionada à execução de modelos, amostragem e raciocínio. Desenvolvida em parceria com o Google DeepMind, essa especialização foi associada às necessidades de modelos com raciocínio e agentes de IA no anúncio de abril.
TPU 8tx combina inferência confidencial e treinamento menor
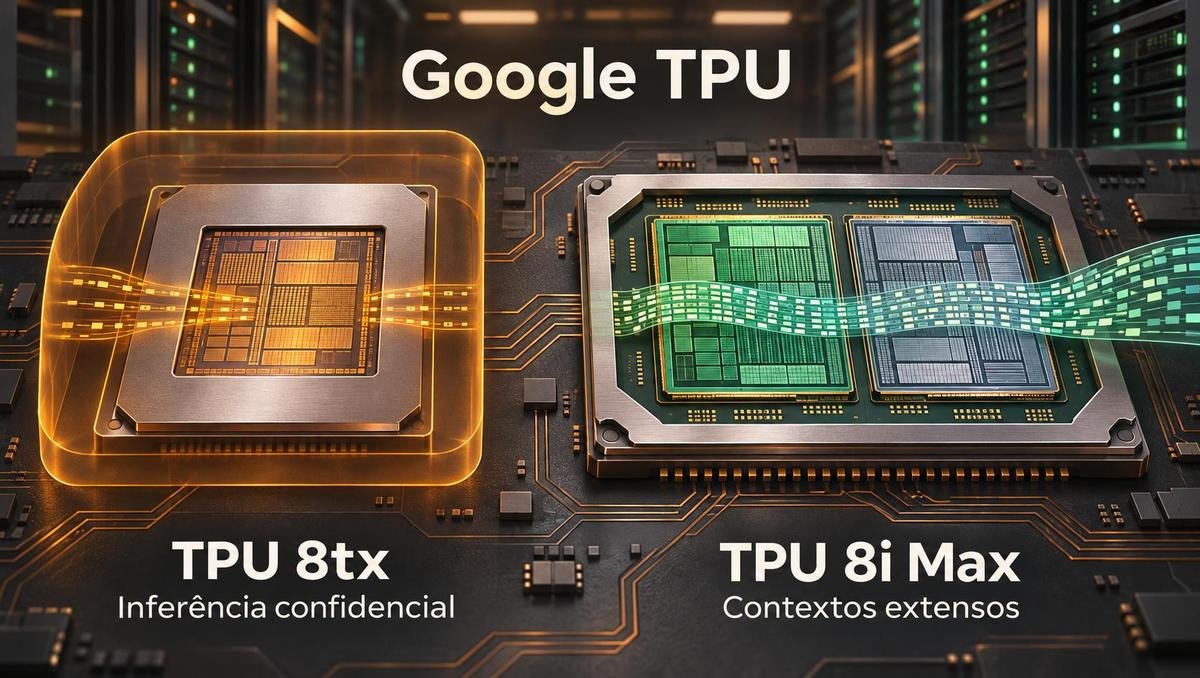
A TPU 8tx utiliza o silício da 8t, processadores hospedeiros AMD EPYC de quinta geração e a rede Boardfly. O Google anuncia latência até duas vezes menor em comparação com a 8t e destaca inferência confidencial e treinamento em menor escala como prioridades do sistema. A descrição está no anúncio oficial.
A proposta inclui ajuste fino privado, destilação de modelos e treinamento de agentes por aprendizado por reforço no mesmo sistema. Para essas tarefas, reunir as etapas reduz a necessidade de transportar dados sensíveis entre clusters separados.
Governos e empresas de setores regulados estão entre os públicos destacados. A promessa é proteger e isolar tanto os dados quanto os pesos dos modelos durante o processamento, com mecanismos implementados em hardware.
Na definição geral de computação confidencial do Google Cloud, essa proteção usa ambientes de execução confiáveis baseados em hardware. A atestação remota verifica a integridade do ambiente; esses conceitos explicam a categoria, mas não estabelecem os detalhes específicos de atestação ou gestão de chaves da 8tx.
TPU 8i Max reúne dois chips para contextos extensos
A TPU 8i Max reúne dois chips 8i em um encapsulamento. Segundo o Google, a configuração duplica computação, SRAM e largura de banda da memória HBM em relação à 8i, com foco em contextos extensos e maior densidade computacional por rack. Esses são os ganhos descritos no anúncio de novembro.
Para entender a origem das variantes, a tabela abaixo reúne as especificações das arquiteturas apresentadas em abril. Os números pertencem às TPU 8t e TPU 8i originais, não constituem uma ficha técnica da 8tx ou da 8i Max.
| Característica | TPU 8t | TPU 8i |
|---|---|---|
| Carga principal | Pré-treinamento em grande escala | Amostragem, execução e raciocínio |
| Rede | Toro tridimensional | Boardfly |
| Capacidade HBM | 216 GB | 288 GB |
| SRAM no chip | 128 MB | 384 MB |
| Pico de computação FP4 | 12,6 PFLOPs | 10,1 PFLOPs |
| Largura de banda HBM | 6.528 GB/s | 8.601 GB/s |
Os dados são da análise técnica do Google Cloud. Nesse documento, a Boardfly reduz a quantidade de saltos de comunicação entre chips: em um conjunto de 1.024 chips, o diâmetro da rede passa de 16 saltos no toro tridimensional para sete.
Essa organização busca favorecer comunicações entre todos os participantes do sistema, comuns em modelos de mistura de especialistas, conhecidos como MoE. A escolha da rede, portanto, acompanha o tipo de comunicação exigido pela carga.
TorchTPU e TPU Sync ampliam o suporte de software
O hardware chega acompanhado de mudanças nas ferramentas de desenvolvimento. Em 20 de outubro de 2026, o Google abriu o código do TorchTPU, desenvolvido com a equipe do PyTorch na Meta para executar cargas PyTorch em TPUs com APIs familiares e alterações mínimas.
O anúncio do TorchTPU cita integrações com vLLM, SGLang, llm-d, TorchTitan, Ray, TorchRec e Hugging Face. Embora a apresentação geral de novembro fale em uso sem reescrita de código, a descrição específica da ferramenta prevê alterações mínimas; equipes devem considerar ajustes na migração de cargas existentes.
Em 9 de novembro, o Google também apresentou o TPU Sync, uma biblioteca C++ aberta para movimentar estados de modelos, caches e pesos entre memórias e sistemas. Ela transfere blocos de cache KV da HBM para a memória dos servidores e conecta etapas separadas de processamento inicial do contexto, o *prefill*, e geração de tokens, o *decode*.
Nos testes divulgados pela empresa, a biblioteca reduziu mais de 90% da latência de transferência KV e, em média, 90% do tempo até o primeiro token em determinadas cargas com modelos MoE de 235 bilhões a 480 bilhões de parâmetros. A comparação usa execução sem TPU Sync; esses percentuais não representam uma medição geral da 8i Max.
A integração com pipelines de aprendizado por reforço e a transferência para armazenamento secundário compartilhado ainda são descritas como experimentais.
Preços e oferta no Brasil seguem sem confirmação
Até a publicação desta matéria, não estavam confirmados preço específico, data de disponibilidade geral ou oferta brasileira das TPU 8tx e TPU 8i Max. A relação oficial de regiões e zonas não apresentava os novos sistemas, enquanto a página comercial ainda identificava 8t e 8i como “Coming soon”.
Para referência de orçamento, a tabela de preços listava Ironwood em Iowa, na região `us-central1`, por US$ 12 por chip/hora sob demanda. Os valores caíam para US$ 8,40 com compromisso de um ano e US$ 5,40 com compromisso de três anos; são preços da geração anterior e não devem ser aplicados às novidades.
A cobrança acumula enquanto o nó está no estado `READY`. Produto, região e modalidade de contratação alteram o custo, fatores que precisam entrar no planejamento antes de reservar infraestrutura.
Provisionamento exige atenção à API, à cota e à capacidade
A documentação atual recomenda Compute Engine ou Google Kubernetes Engine para provisionar TPUs, conforme a necessidade de gerenciamento e orquestração. A API legada Cloud TPU deixou de receber desenvolvimento ativo.
O tutorial oficial de criação de instâncias usa TPU v6e/Trillium e exige projeto Google Cloud, faturamento habilitado, API Compute Engine e permissões IAM. Essas orientações ajudam no preparo do ambiente, mas não confirmam um procedimento de contratação das variantes anunciadas.
No GKE, o erro `Insufficient quota to satisfy the request` exige verificar limite e consumo do projeto e solicitar aumento quando necessário. A orientação de solução de problemas esclarece que o serviço utiliza a cota da API Compute Engine, diferente da cota da API Cloud TPU.
Já falhas de capacidade podem exigir outra zona recomendada, configuração diferente ou menos recursos. Para `ACCELERATOR_INTERCONNECT_CONFIG_FAILED`, a recomendação é aguardar alguns minutos e repetir a solicitação, conforme a documentação de disponibilidade de recursos.
A escolha do acelerador começa pelas operações do modelo
A documentação geral considera menos adequados às TPUs programas com desvios frequentes, muitas operações elemento a elemento, exigência de alta precisão ou operações personalizadas no laço principal de treinamento. Esses critérios ajudam a avaliar a compatibilidade antes de planejar a migração, segundo a visão geral das TPUs.
Para quem precisa de uma oferta já documentada comercialmente, Ironwood/TPU7x aparecia como geralmente disponível no portfólio do Google Cloud. Fora desse ecossistema, as instâncias Amazon EC2 Trn2 atendem treinamento e inferência de IA generativa com 16 chips Trainium2 por instância e software AWS Neuron.
CPUs e GPUs também entram na avaliação. A orientação do Google Cloud indica CPUs para prototipação flexível e modelos pequenos, enquanto GPUs podem atender melhor a operações personalizadas ou não suportadas pelas TPUs.
Fontes
- Google: anúncio das TPU 8tx e TPU 8i Max
- Google Cloud: arquitetura das TPU 8t e TPU 8i
- Google Cloud: TorchTPU de código aberto
- Google Cloud: apresentação do TPU Sync
- Google Cloud: preços de TPU
- Google Cloud: regiões e zonas
- AWS: instâncias Amazon EC2 Trn2
Perguntas frequentes
Qual é a diferença entre treinamento e inferência?
Treinamento é a etapa de desenvolvimento do modelo; inferência é sua execução para gerar respostas ou realizar outras tarefas. A oitava geração do Google separa arquiteturas voltadas a essas necessidades.
Ter cota disponível garante a criação de uma TPU?
Não. A cota autoriza o consumo de recursos pelo projeto, mas o provisionamento também exige capacidade física disponível na infraestrutura.
Os preços das TPUs são por chip ou por máquina virtual?
A tabela comercial usa chip/hora, enquanto o console apresenta o faturamento em horas de máquina virtual. Uma máquina virtual pode reunir vários chips.
A TPU substitui a GPU em qualquer aplicação?
Não. A escolha exige avaliar as operações do modelo: GPUs podem atender melhor a cargas com operações personalizadas, enquanto CPUs são uma opção para protótipos e modelos pequenos.