Avaliação de IA em saúde: Google propõe combinar três métodos
Neste artigo
- Avaliação de IA em saúde vai além de acertar respostas
- O processo começa pelas tarefas de quem usa o sistema
- Rubricas adaptativas ajudam a examinar respostas abertas
- Privacidade e confiança excessiva exigem avaliação própria
- O que a proposta representa para desenvolvedores e instituições
- Outras estruturas ampliam os critérios de análise
- Fontes
- Perguntas frequentes
Uma IA que responde corretamente a uma pergunta médica ainda precisa demonstrar que sua resposta é segura e útil para quem a recebe. Uma proposta de avaliação de IA em saúde apresentada por pesquisadores do Google combina testes, pontuação automática e revisão especializada para orientar decisões de desenvolvimento, contratação e implantação desses sistemas.
Avaliação de IA em saúde vai além de acertar respostas
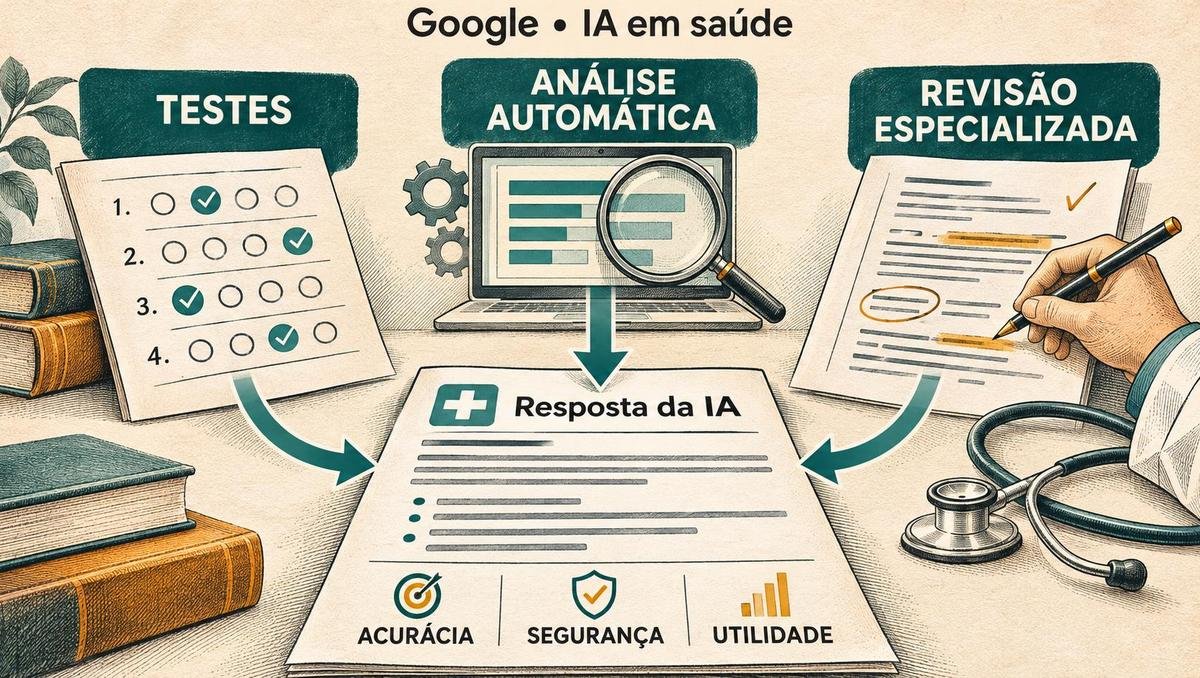
O trabalho *Towards Multi-Method Evaluation of AI in Health: Integrating Benchmarks, Autoraters, and Expert Evaluation* organiza a análise em três dimensões: precisão, segurança e utilidade. A proposta procura aproximar os resultados obtidos em laboratório do desempenho nas situações em que consumidores, profissionais e instituições usam a tecnologia. O manuscrito está disponível no arXiv.
Essa divisão muda a pergunta central da avaliação. Em vez de verificar somente se uma resposta contém informações corretas, o processo também examina o risco associado a ela e sua contribuição para a tarefa que o usuário precisa realizar.
São critérios separados porque uma boa pontuação em conhecimento médico não resolve, por si só, a avaliação de um produto. A utilidade prática e a segurança precisam ser examinadas dentro da finalidade prevista para o sistema.
A versão v1 do manuscrito foi submetida em 3 de novembro de 2026. Sarah Montgomery-Taylor é a primeira autora, com Michael Howell, Dana Gelb Safran e Elizabeth A. McGlynn entre os coautores. Até a publicação desta matéria, a revisão por pares desse novo trabalho não estava confirmada.
O processo começa pelas tarefas de quem usa o sistema
O ponto de partida são as *Critical User Journeys*, ou jornadas críticas dos usuários. Nessa etapa, a equipe identifica quem vai utilizar a ferramenta, quais objetivos essas pessoas têm e quais tarefas merecem prioridade na avaliação.
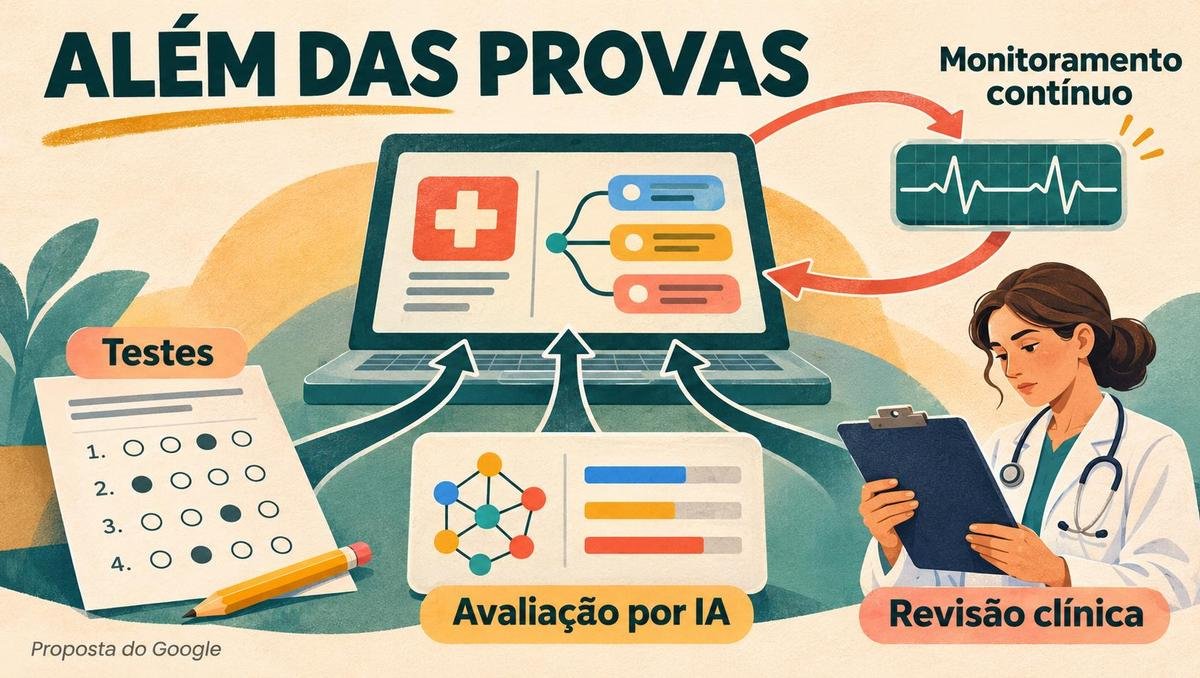
A partir desse recorte, o framework combina três métodos: testes com perguntas fechadas, modelos que atribuem pontuações às respostas e revisão humana especializada. A estrutura acompanha tanto o desenvolvimento do modelo quanto a construção do produto e seu monitoramento depois da implantação, conforme o manuscrito completo.
O acompanhamento posterior importa porque a proposta trata a avaliação como parte do ciclo de uso do sistema. Uma decisão de implantação precisa considerar o produto e suas tarefas, além do desempenho isolado do modelo.
Há também uma exigência para os chamados avaliadores automáticos: suas notas precisam ser validadas contra julgamentos clínicos humanos. O próprio trabalho reconhece que esses avaliadores podem apresentar vieses. Automatizar parte da análise amplia a capacidade de avaliação, mas mantém a necessidade de verificar a qualidade de quem está pontuando.
Rubricas adaptativas ajudam a examinar respostas abertas
Uma pesquisa distinta, apresentada anteriormente pelo Google Research, explora como tornar mais consistente a avaliação de respostas de modelos de linguagem em saúde. O método divide critérios amplos em perguntas específicas, respondidas com “sim” ou “não”.
Na versão adaptativa, entram na avaliação apenas os critérios pertinentes à resposta e aos dados examinados. O Gemini foi usado para classificar essa pertinência, segundo a descrição técnica do Google Research.
No experimento, as rubricas adaptativas alcançaram maior concordância entre avaliadores e exigiram aproximadamente metade do tempo das avaliações por escala Likert, que usa níveis graduais de pontuação. Esse resultado pertence ao estudo das rubricas, separado do novo framework, e não comprova ganho equivalente em qualquer avaliação de IA médica.
A validação concentrou-se em saúde metabólica, incluindo diabetes, doenças cardiovasculares e obesidade. Portanto, os resultados desse experimento não estabelecem desempenho universal em outras especialidades. O artigo na *npj Digital Medicine* reúne os detalhes do estudo.
O Google Research também reconhece que escalas graduais continuam úteis quando a análise precisa preservar nuances. A escolha do instrumento de avaliação acompanha o tipo de julgamento necessário; perguntas binárias não eliminam todas as situações em que uma resposta exige apreciação mais detalhada.
Privacidade e confiança excessiva exigem avaliação própria
A segurança de uma IA de saúde envolve tanto o conteúdo das respostas quanto a proteção das informações utilizadas. A Organização Mundial da Saúde alerta que modelos generativos podem produzir informações falsas, incompletas ou enviesadas e sofrer ataques que comprometam dados de pacientes.
Outro risco é o viés de automação: aceitar a resposta da IA sem perceber seus erros. Nas orientações sobre ética e governança de modelos multimodais, a OMS recomenda envolver profissionais, pacientes e outros interessados desde o desenvolvimento.
Para sistemas implantados em larga escala, a organização recomenda auditorias independentes, incluindo avaliações de proteção de dados e direitos humanos. Também orienta separar os resultados por grupos de usuários, para que a análise não fique restrita a uma medida geral de desempenho.
No estudo anterior sobre rubricas adaptativas, os pesquisadores utilizaram dados desidentificados do WEAR-ME, pesquisa com aproximadamente 1.500 participantes. O conjunto envolveu informações de dispositivos vestíveis, biomarcadores e questionários. Esse recorte descreve os dados daquele experimento; aplicações com informações de pacientes precisam considerar seus próprios controles de privacidade.
O que a proposta representa para desenvolvedores e instituições
O novo framework se dirige a decisões sobre construção, contratação e implantação de IA em saúde. Até a publicação desta matéria, não havia confirmação de adoção específica no Brasil nem de validação em português brasileiro. Para uma instituição brasileira, essas lacunas afetam a avaliação da adequação ao público e às tarefas locais.
Em uma iniciativa relacionada, o Health AI Developer Foundations, ou HAI-DEF, o Google orienta os desenvolvedores a consultar o cartão de cada modelo. Esses documentos descrevem finalidade prevista, limitações, formatos de dados e avaliações de desempenho.
A documentação do HAI-DEF atribui ao desenvolvedor a responsabilidade de testar os próprios dados e tarefas, adaptar o modelo quando necessário e repetir a avaliação antes de colocá-lo em produção. Essa orientação pertence à família HAI-DEF, que deve ser distinguida do framework recém-apresentado.
Para equipes interessadas em examinar a construção das rubricas adaptativas, os materiais suplementares do estudo anterior incluem informações sobre prompts, perguntas, personas sintéticas e critérios de avaliação. Esses registros ajudam a entender como o experimento foi organizado e quais escolhas sustentaram seus resultados.
Outras estruturas ampliam os critérios de análise
O HAICEF oferece outra organização para avaliar chatbots de saúde. A estrutura reúne 271 perguntas e 18 categorias de segundo nível, distribuídas em três prioridades: segurança, privacidade e equidade; confiabilidade e utilidade; desenho e eficácia operacional. O estudo do HAICEF ainda prevê validação prospectiva.
Outra abordagem foi aplicada ao ClinicalKey AI, com participação de 41 médicos e farmacêuticos certificados. A avaliação examinou compreensão, utilidade, correção, completude e potencial de dano clínico, além de adotar um protocolo para resolver divergências de pontuação entre os profissionais. O método está descrito no estudo sobre avaliação reproduzível de IA em saúde.
Já as orientações da OMS concentram-se em ética e governança, com mais de 40 recomendações para governos, empresas e prestadores de saúde. Elas acrescentam critérios sobre supervisão, direitos e proteção de dados à medição técnica de desempenho.
Para quem precisa escolher ou avaliar uma ferramenta, esses trabalhos oferecem perguntas concretas: ela foi examinada nas tarefas previstas, os julgamentos automáticos foram conferidos por especialistas e o acompanhamento continua após a implantação? São decisões que precisam aparecer no processo de avaliação, antes que uma nota de desempenho sustente a adoção do sistema.
Fontes
- Google Research: metodologia de rubricas adaptativas para modelos de saúde
- ArXiv: Towards Multi-Method Evaluation of AI in Health
- Google for Developers: perguntas frequentes do HAI-DEF
- OMS: orientações de ética e governança para IA multimodal
- npj Digital Medicine: estudo sobre rubricas adaptativas
- Estudo sobre a estrutura HAICEF
- Estudo sobre avaliação reproduzível com profissionais de saúde
Perguntas frequentes
Uma resposta de IA pode estar correta e ainda oferecer risco?
Sim. Acertar uma informação médica não basta para garantir uma orientação segura e adequada à tarefa de quem perguntou.
Os avaliadores automáticos substituem os profissionais de saúde?
A proposta mantém a revisão especializada e exige comparar as notas automáticas com julgamentos clínicos humanos.
O novo framework tem validação em português brasileiro?
Até a publicação desta matéria, não havia confirmação de validação em português brasileiro ou de adoção específica no Brasil.
O HAI-DEF é o framework anunciado pelo Google?
São iniciativas distintas. O HAI-DEF reúne ferramentas para desenvolvedores, enquanto o novo trabalho propõe uma estrutura de avaliação.
Como examinar a confiabilidade de um chatbot de saúde?
A análise precisa incluir segurança, privacidade, equidade, correção e utilidade no contexto de uso. Estruturas como o HAICEF organizam esses critérios, mas seu estudo ainda prevê validação prospectiva.