IA em saúde: Google propõe avaliação além das provas médicas
Neste artigo
- IA em saúde precisa de avaliação ao longo do uso
- O ponto de partida são as tarefas de cada usuário
- Provas médicas deixam de fora parte do trabalho clínico
- Rubricas booleanas são uma pesquisa anterior e distinta
- Segurança envolve dados, equidade e acompanhamento contínuo
- Brasil: finalidade de uso orienta o enquadramento regulatório
- Outros frameworks cobrem adoção clínica e agentes
- Fontes
- Perguntas frequentes
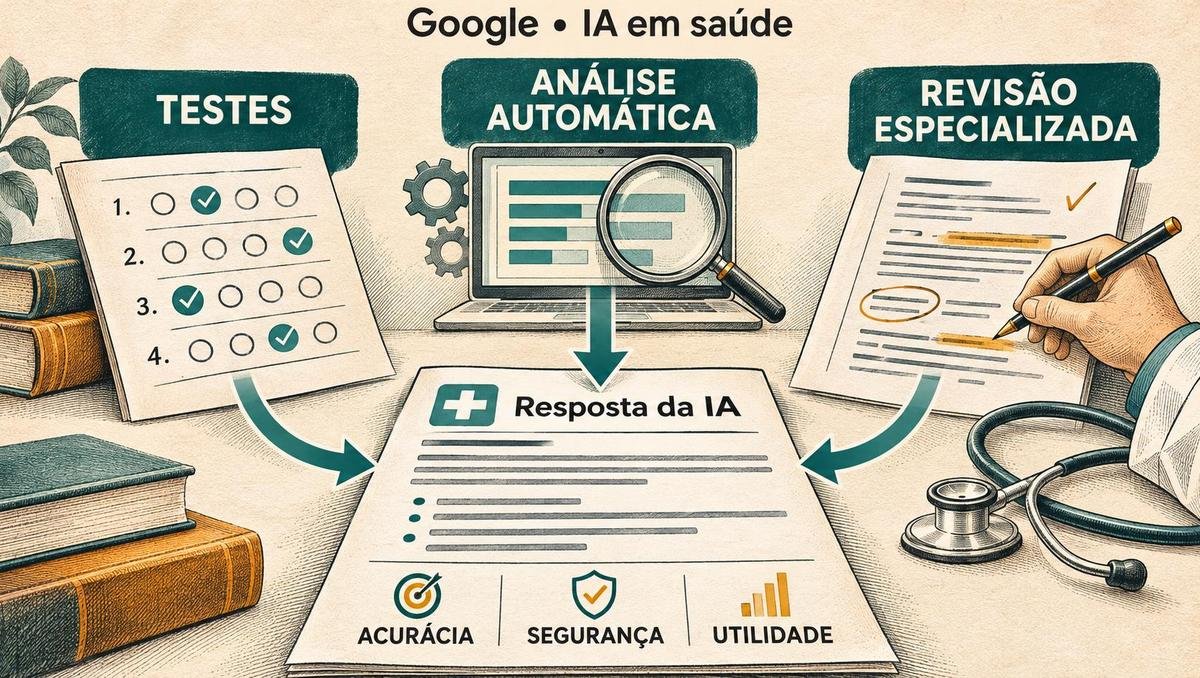
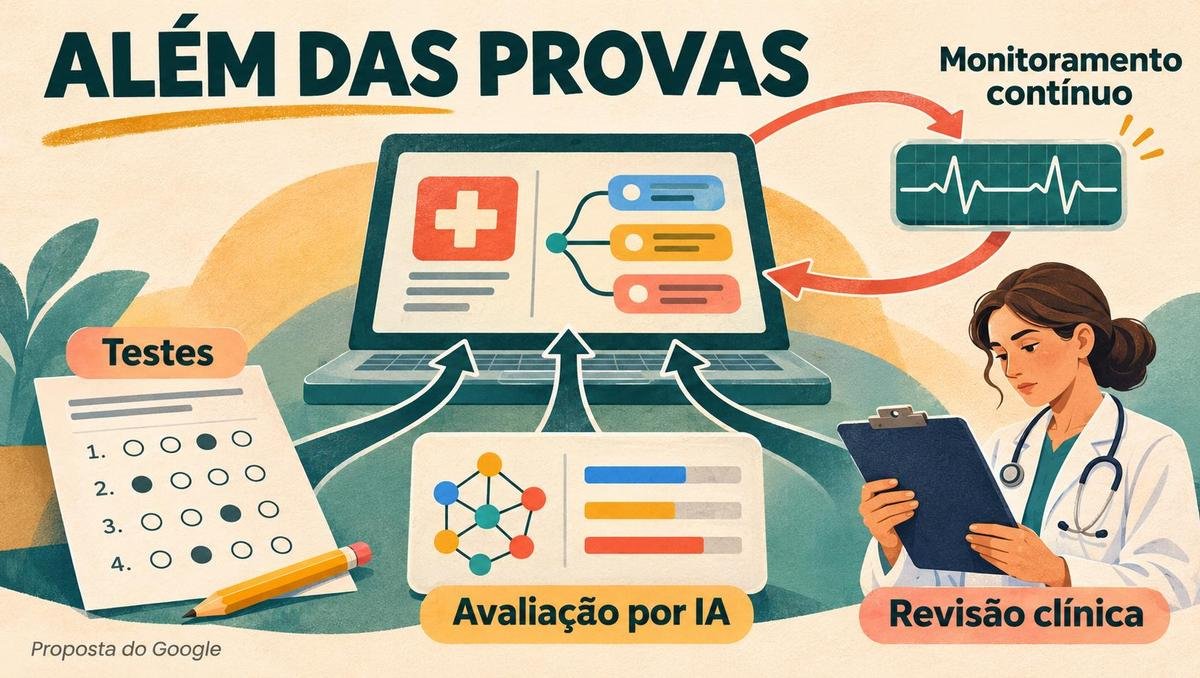
Avaliar IA em saúde exige verificar mais do que respostas certas em uma prova: também importa o que uma pessoa pode fazer depois de receber a orientação. Um novo trabalho do Google propõe combinar testes, modelos avaliadores e revisão humana para examinar precisão, segurança e utilidade desde o desenvolvimento até o uso real.
IA em saúde precisa de avaliação ao longo do uso
O artigo *Towards Multi-Method Evaluation of AI in Health: Integrating Benchmarks, Autoraters, and Expert Evaluation* apresenta uma metodologia para apoiar o desenvolvimento, a aquisição e a implantação de modelos e aplicações de IA generativa em saúde. A proposta organiza diferentes formas de avaliação conforme a tarefa, o risco e os recursos disponíveis.
A primeira versão foi submetida em 3 de novembro de 2026. O documento reúne 32 autores, entre eles Sarah Montgomery-Taylor, Dana Gelb Safran, Elizabeth A. McGlynn e Michael Howell, segundo o registro no arXiv.
A metodologia acompanha três fases: desenvolvimento do modelo-base, construção do produto e monitoramento após a implantação. Essa divisão coloca a avaliação também no período em que a ferramenta já está em uso, em vez de concentrar toda a análise nos testes anteriores ao lançamento.
Para equipes que desenvolvem ou compram essas soluções, a proposta oferece uma estrutura para escolher evidências adequadas ao uso pretendido. Um resultado agregado de desempenho passa a ser parte da análise, acompanhado por verificações específicas das tarefas e dos riscos.
O ponto de partida são as tarefas de cada usuário
O framework começa pelas *Critical User Journeys*, ou CUJs. São descrições que identificam quem usará o sistema, qual objetivo pretende alcançar e quais tarefas precisa executar.
Esse recorte orienta a seleção de testes representativos. A avaliação parte do trabalho esperado da ferramenta, para então escolher como medir seu desempenho, conforme o texto integral do artigo.
A proposta combina três métodos:
- Benchmarks de perguntas fechadas, que ajudam a medir conhecimento em conjuntos definidos de questões.
- Modelos usados como avaliadores, chamados de *autoraters*, para examinar respostas.
- Revisão humana especializada, que acrescenta julgamento clínico à análise.
Os métodos podem receber pesos diferentes conforme o risco e os recursos disponíveis. Avaliadores automáticos também podem apresentar vieses, por isso seus julgamentos precisam ser confrontados com a avaliação de especialistas.
A segurança recebe uma definição que vai além da exatidão factual. O framework considera possíveis danos decorrentes da interpretação ou das ações do usuário, inclusive quando a resposta contém informações corretas. Assim, verificar a veracidade de uma frase não encerra a análise sobre suas consequências.
Provas médicas deixam de fora parte do trabalho clínico
A distância entre responder questões e executar tarefas aparece também em pesquisas independentes. Em publicação de 19 de outubro de 2026, o Stanford HAI diferencia o conhecimento medido por provas médicas das atividades que exigem lidar com documentos, sistemas e decisões encadeadas.
A instituição apresenta MedHELM, PhysicianBench e HealthAdminBench para explorar essa diferença. O PhysicianBench inclui testes de agentes em ambientes funcionais de prontuário eletrônico; o HealthAdminBench examina atividades administrativas.
Essas abordagens ajudam a investigar dificuldades que uma nota em questionário pode deixar de fora. Uma ferramenta pode conhecer a resposta a uma pergunta e ainda enfrentar obstáculos para completar uma atividade com várias etapas.
Outro problema aparece quando muitos modelos atingem pontuações muito altas no mesmo benchmark: o teste perde capacidade de distingui-los. A documentação de avaliação do Google recomenda conjuntos complementares de segurança e alerta que diferenças na implementação dos testes podem alterar os resultados.
Rubricas booleanas são uma pesquisa anterior e distinta
O novo framework se relaciona com uma linha de pesquisa sobre avaliação de respostas, mas não deve ser confundido com o estudo das *Adaptive Precise Boolean rubrics*. Esse trabalho transforma critérios complexos em perguntas de “sim” ou “não” e seleciona aquelas pertinentes a cada resposta.
A abordagem foi validada em saúde metabólica, incluindo diabetes, doenças cardiovasculares e obesidade. Nesse estudo, as rubricas adaptativas aumentaram a concordância entre avaliadores e reduziram o tempo de avaliação para aproximadamente metade do exigido por escalas Likert, segundo a publicação na npj Digital Medicine.
O ganho está restrito ao contexto pesquisado. O Google Research reconhece que escalas Likert ainda podem captar nuances úteis e aponta a necessidade de ampliar a diversidade dos perfis de usuários e das áreas de saúde avaliadas.
O material suplementar disponibiliza prompts, perguntas, personas sintéticas e critérios de avaliação. Os modelos foram usados em ambiente controlado de pesquisa; aplicações reais exigiriam validação própria e eventual análise regulatória.
Segurança envolve dados, equidade e acompanhamento contínuo
A avaliação de uma ferramenta de saúde também precisa alcançar o tratamento de dados e as diferenças de desempenho entre grupos. Nas orientações publicadas em janeiro de 2024, a Organização Mundial da Saúde identifica riscos de respostas falsas, incompletas ou enviesadas, confiança excessiva na automação e ataques que comprometam dados de pacientes.
A OMS recomenda auditorias e avaliações de impacto por terceiros independentes após lançamentos em grande escala. Essas análises devem incluir proteção de dados e resultados separados por grupos de usuários.
Há ferramentas voltadas especificamente à equidade. O HEAL, apresentado pelo Google Research em março de 2024, propõe um processo de quatro etapas para avaliar quantitativamente a equidade do desempenho de sistemas de aprendizado de máquina em saúde.
Na documentação geral de segurança, o Google distingue avaliações durante o desenvolvimento, verificações de garantia para governança, testes adversariais por equipes especializadas e avaliações externas independentes. São orientações complementares, aplicáveis também fora da saúde.
Brasil: finalidade de uso orienta o enquadramento regulatório
Até a publicação desta matéria, não havia confirmação de implantação do novo framework em instituições brasileiras nem de cronograma de adoção no país.
Para softwares com IA destinados à saúde, a Anvisa orienta que o enquadramento como dispositivo médico depende da finalidade de uso. Sua documentação também exige a descrição das bases usadas para aprendizado, treinamento e verificação, incluindo origem e quantidade dos dados.
No campo da pesquisa, o Ministério da Saúde anunciou em setembro de 2026 um guia aprovado pela Inaep e a ferramenta Mariah. Destinada a apoiar comitês de ética na identificação e classificação de riscos, a ferramenta tinha previsão de seis meses iniciais de testes pelos comitês.
Outros frameworks cobrem adoção clínica e agentes
A proposta do Google integra um campo que já reúne abordagens com diferentes escopos. Publicado em 2021, o TEHAI avalia capacidade técnica, utilidade e adoção de sistemas de IA em saúde, acompanhando a transição da pesquisa para o uso clínico.
A Coalition for Health AI também publicou um framework para IA agêntica, na versão 1.0, anunciado em julho de 2026. O documento reúne métodos e métricas para utilidade, usabilidade, eficácia, equidade, segurança, confiabilidade e impacto no negócio.
Para aplicações de bem-estar com IA generativa, a organização mantém outro guia de boas práticas e testes. Seu escopo inclui delimitação do produto, privacidade, interação saudável com usuários, resposta a crises e monitoramento contínuo.
A escolha entre essas referências deve acompanhar a finalidade da ferramenta: avaliação técnica, transição para o cuidado clínico, execução de tarefas por agentes ou interação em produtos de bem-estar. Cada escopo exige evidências compatíveis com o trabalho que o sistema pretende realizar.
Fontes
- Artigo dos autores: framework de avaliação de IA em saúde, no arXiv
- Stanford HAI: avaliação de tarefas médicas e administrativas
- npj Digital Medicine: estudo das rubricas booleanas adaptativas
- OMS: ética e governança de modelos multimodais em saúde
- Anvisa: perguntas e respostas sobre software como dispositivo médico
- BMJ Health & Care Informatics: framework TEHAI
Perguntas frequentes
Uma nota alta em prova médica comprova que uma IA está pronta para um hospital?
Não. Questões fechadas medem conhecimento, enquanto o trabalho hospitalar envolve consultar documentos, operar sistemas e completar tarefas encadeadas.
Outra IA pode avaliar respostas sobre saúde?
Pode participar da avaliação, mas seus julgamentos também precisam ser verificados. O framework combina esse recurso com testes e análise humana especializada.
Todo aplicativo de saúde com IA precisa de regularização na Anvisa?
O enquadramento depende da finalidade de uso e da classificação como dispositivo médico. A presença de inteligência artificial, isoladamente, não define essa obrigação.
O novo framework já foi adotado no Brasil?
Até a publicação desta matéria, não havia confirmação de implantação em instituições brasileiras nem de cronograma de adoção no país.
O framework de novembro é o mesmo estudo das rubricas booleanas?
Não. São trabalhos distintos: o framework reúne diferentes métodos de avaliação, enquanto a pesquisa anterior explora critérios adaptativos formulados como perguntas de “sim” ou “não”.