Gemini 4 Neon chega para programação e tarefas empresariais
Neste artigo
- Gemini 4 Neon ocupa o espaço entre Hydrogen e Carbon
- Quem recebe o modelo e quanto custa o acesso
- Selecionando Neon no Gemini pelo Android
- Entradas multimodais e contexto variam por produto
- Antigravity combina planejamento com execução
- Ajustes na API evitam erros durante a migração
- Conhecimento, segurança e histórico exigem atenção
- Fontes
- Perguntas frequentes
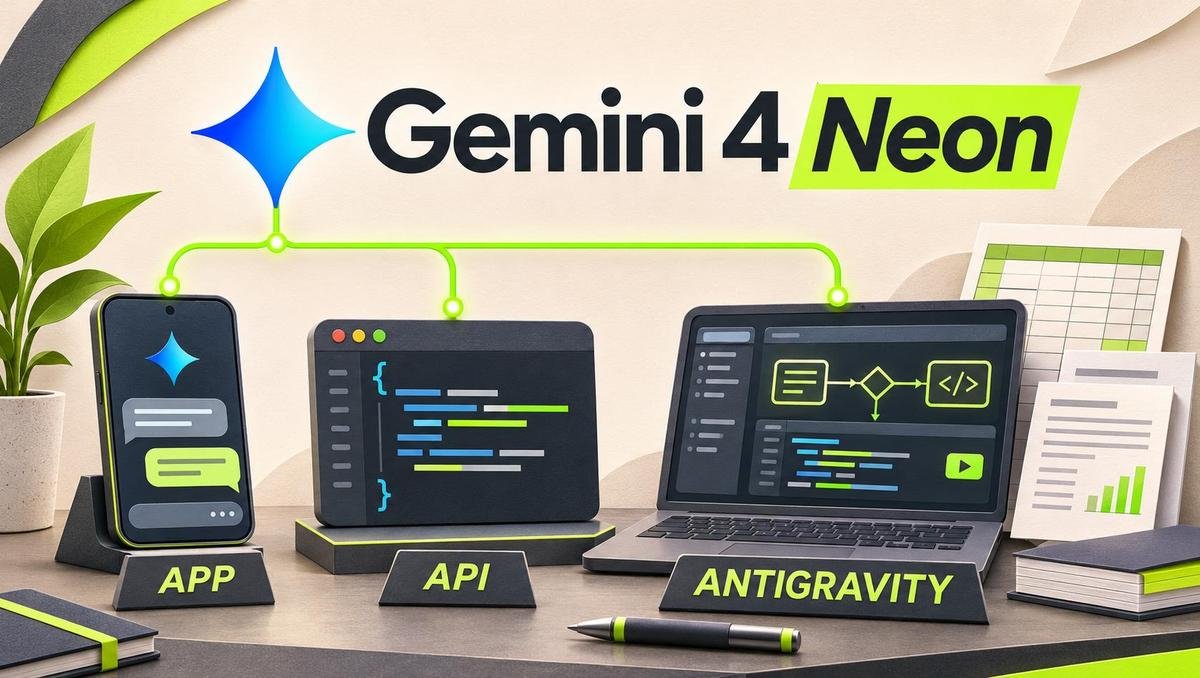
O Gemini 4 Neon chega para atender quem precisa trabalhar com código complexo, raciocínio analítico e tarefas empresariais. Anunciado pelo Google em 18 de novembro de 2026, o modelo começou a ser distribuído no app Gemini, na API paga, no AI Studio, no Gemini for business e no Antigravity, com acesso condicionado às regras de cada produto.
Gemini 4 Neon ocupa o espaço entre Hydrogen e Carbon
Desenvolvido pelo Google DeepMind, Neon fica entre dois modelos da família: Hydrogen, destinado à execução cotidiana rápida, e Carbon, direcionado a projetos mais difíceis e prolongados. O anúncio do Google apresenta essa posição como uma opção para programação e trabalho empresarial.
O cartão técnico do DeepMind informa que Neon foi adaptado de Carbon. Já o guia empresarial recomenda sua adoção como atualização de Gemini 3.1 Pro e para trabalhos gerais de programação e raciocínio antes realizados com Argon. Essa orientação estabelece uma rota de migração, sem anunciar encerramento universal dos modelos anteriores.
As avaliações externas oferecem duas referências: a Artificial Analysis registra 61 pontos em seu índice de inteligência, com esforço Xhigh, enquanto a Vals AI registra 70,9% no Vals Index. Cada resultado corresponde ao teste e à configuração utilizados; os números não formam uma escala única de comparação.
Quem recebe o modelo e quanto custa o acesso
Até a publicação desta matéria, a ajuda do app Gemini listava Neon para assinantes Google AI Pro e Ultra. A documentação empresarial identificava `gemini-4-neon` em disponibilidade geral desde 18 de novembro, com acesso restrito a clientes empresariais verificados em regiões selecionadas. A disponibilidade para contas brasileiras não estava confirmada.
No Antigravity, a oferta inclui Google AI Ultra, Pro pago, testes vinculados a dispositivos premium elegíveis e Gemini Enterprise. Os planos Free e Plus desse produto não incluem Neon, segundo a documentação de modelos.
Para a API, o Google anunciou estes preços em dólares:
- US$ 3 por milhão de tokens de entrada.
- US$ 0,15 por milhão de tokens de entrada em cache.
- US$ 15 por milhão de tokens de saída.
O valor de entrada em cache representa desconto de 95% sobre a entrada comum. Até a publicação, os preços brasileiros de assinatura especificamente associados ao lançamento não estavam confirmados.
Selecionando Neon no Gemini pelo Android
O acesso ao modelo depende do canal e da assinatura, sem exigência de hardware local específico no cartão técnico. Para encontrar a opção no Android, a ajuda oficial do Gemini orienta a seguinte sequência:
- Abra o app Gemini ou acesse gemini.google.com no celular ou tablet Android.
- Toque no modelo atualmente selecionado, na parte inferior da caixa de conversa.
- Selecione Neon. Um cadeado indica que a conta precisa de um plano elegível.
- Escolha, opcionalmente, Low, Medium ou High para ajustar o nível de raciocínio.
Na seleção manual pelo Android, o padrão informado é Low. O modelo e o nível escolhidos permanecem associados à conversa, inclusive quando você volta a ela mais tarde.
Essas opções pertencem ao aplicativo. O Antigravity tem outro conjunto de níveis e outro padrão, por isso suas configurações precisam ser conferidas separadamente.
Entradas multimodais e contexto variam por produto
Na ficha do serviço empresarial do Google Cloud, Neon recebe texto, imagens, áudio e vídeo, mas responde em texto. Também aceita PDF e arquivos de escritório, incluindo `.docx`, `.pptx`, `.xlsx`, `.odt`, `.odp` e `.ods`.
O serviço oferece chamadas de funções, execução de código, respostas estruturadas e fundamentação com ferramentas de busca. Esses recursos ampliam as tarefas atendidas pela API, enquanto a mesma documentação lista limitações: Gemini Live API, ajuste fino e RAG Engine ficam fora da oferta empresarial descrita.
Na API, entrada e saída compartilham 1.048.576 tokens. O orçamento de saída inclui raciocínio, chamadas de funções e resposta final; cada segmento gera até 65.536 tokens, conforme os primeiros passos do Google Cloud.
Tokens são unidades usadas para dividir texto e outros dados durante o processamento. Como podem corresponder a caracteres, palavras ou expressões, o total não equivale a uma quantidade fixa de páginas, explica a documentação de contagem.
No Antigravity, a janela documentada é menor: até 512 mil tokens. Ao escolher onde executar um projeto extenso, esse limite precisa ser considerado junto com o conteúdo que será enviado.
Antigravity combina planejamento com execução
O Antigravity oferece Orchestrator (Neon), que combina planejamento e revisão com Neon e execução com Hydrogen. O seletor apresenta Low, Medium, High e Extra, com High como padrão. A opção Extra corresponde a `xhigh` na CLI, segundo a documentação do produto.
O blog do Antigravity relata custo por tarefa 32% menor que Carbon no índice da Artificial Analysis, usando Neon em High. A comparação está vinculada a esse teste e a esse nível de esforço.
A escolha entre modelos também acompanha o tipo de tarefa. O guia do Google direciona Hydrogen a trabalhos frequentes de alto volume, mantém Carbon como opção para projetos mais complexos e prolongados e recomenda Gemini 3.5 Flash-Lite para classificação em grande escala.
Ajustes na API evitam erros durante a migração
Aplicações que migram para Neon precisam revisar parâmetros. Segundo o guia de desenvolvimento, pedidos com `thinking_budget` ou `MINIMAL` podem retornar erro HTTP `400`. A orientação é usar `thinking_level` com `LOW`, `MEDIUM`, `HIGH` ou `XHIGH`.
Os parâmetros `temperature`, `top_p` e `top_k` são ignorados. O controle de raciocínio passa por `thinking_level`, enquanto `response_schema` define o formato da resposta.
Para respostas interrompidas pelo limite de um segmento, a documentação indica long decodes com continuação, recurso que exige o endpoint `v1beta1`. A continuação automática na Interactions API requer Google Gen AI SDK a partir de `google-genai 2.34.0` em Python ou `@google/genai 2.32.0` em JavaScript e TypeScript.
O cache implícito se aplica a prefixos compartilhados de pelo menos 4.096 tokens. Para aproveitar esse mecanismo, o Google recomenda colocar material estático, como documentos extensos, no início do prompt.
A compreensão agêntica de vídeo vem desativada. O parâmetro documentado para habilitá-la na API é:
media_processing="agentic"Conhecimento, segurança e histórico exigem atenção
O cartão técnico reconhece alucinações e registra corte de conhecimento em março de 2026, com informações menos recentes em alguns domínios. Para tarefas que exigem acontecimentos posteriores a essa data, a fundamentação com ferramentas de busca é um recurso relevante.
Na avaliação de segurança citada pelo Google, Neon teve taxa de sucesso de ataque de 0% no teste Gray Swan de injeção indireta de prompts, com salvaguardas em tempo real e esforço máximo. O resultado pertence àquela configuração e àquele conjunto de testes; o próprio cartão técnico mantém a resistência a jailbreaks como área de melhoria.
No aplicativo Gemini, há ainda uma decisão separada sobre histórico. Desativar Manter atividade não elimina imediatamente todo armazenamento: conversas podem permanecer na conta por até 72 horas para prestação do serviço e processamento de feedback, conforme a ajuda de privacidade.
No computador, o caminho documentado passa por Configurações e ajuda, Atividade e Ativada. Nesse ponto, você escolhe Desativar ou Desativar e excluir atividade, conforme queira apenas interromper o histórico ou também remover a atividade existente.
Fontes
- Google: anúncio do Gemini 4 Neon e preços da API
- Google DeepMind: cartão técnico do modelo
- Google Cloud: recursos e restrições empresariais
- Antigravity: modelos, planos e níveis de raciocínio
- Artificial Analysis: avaliação do Gemini 4 Neon
- Vals AI: resultados do Vals Index
Perguntas frequentes
Gemini 4 Neon é gratuito?
O acesso anunciado envolve API paga e assinaturas elegíveis. No Antigravity, os planos Free e Plus ficam fora da oferta.
Neon cria imagens ou arquivos de áudio?
A ficha empresarial descreve processamento de imagens e áudio recebidos, mas entrega respostas em texto.
O modelo pode apresentar informações falsas?
Sim. O cartão técnico reconhece alucinações e registra conhecimento com corte em março de 2026, com cobertura menos recente em alguns assuntos.
A janela de um milhão de tokens fica toda disponível para documentos?
Não. Na API documentada, o conteúdo enviado divide espaço com o raciocínio, as chamadas de funções e a resposta.
A disponibilidade no Brasil está confirmada?
Até a publicação desta matéria, não havia confirmação de liberação específica para contas brasileiras nem de preço local associado ao lançamento.